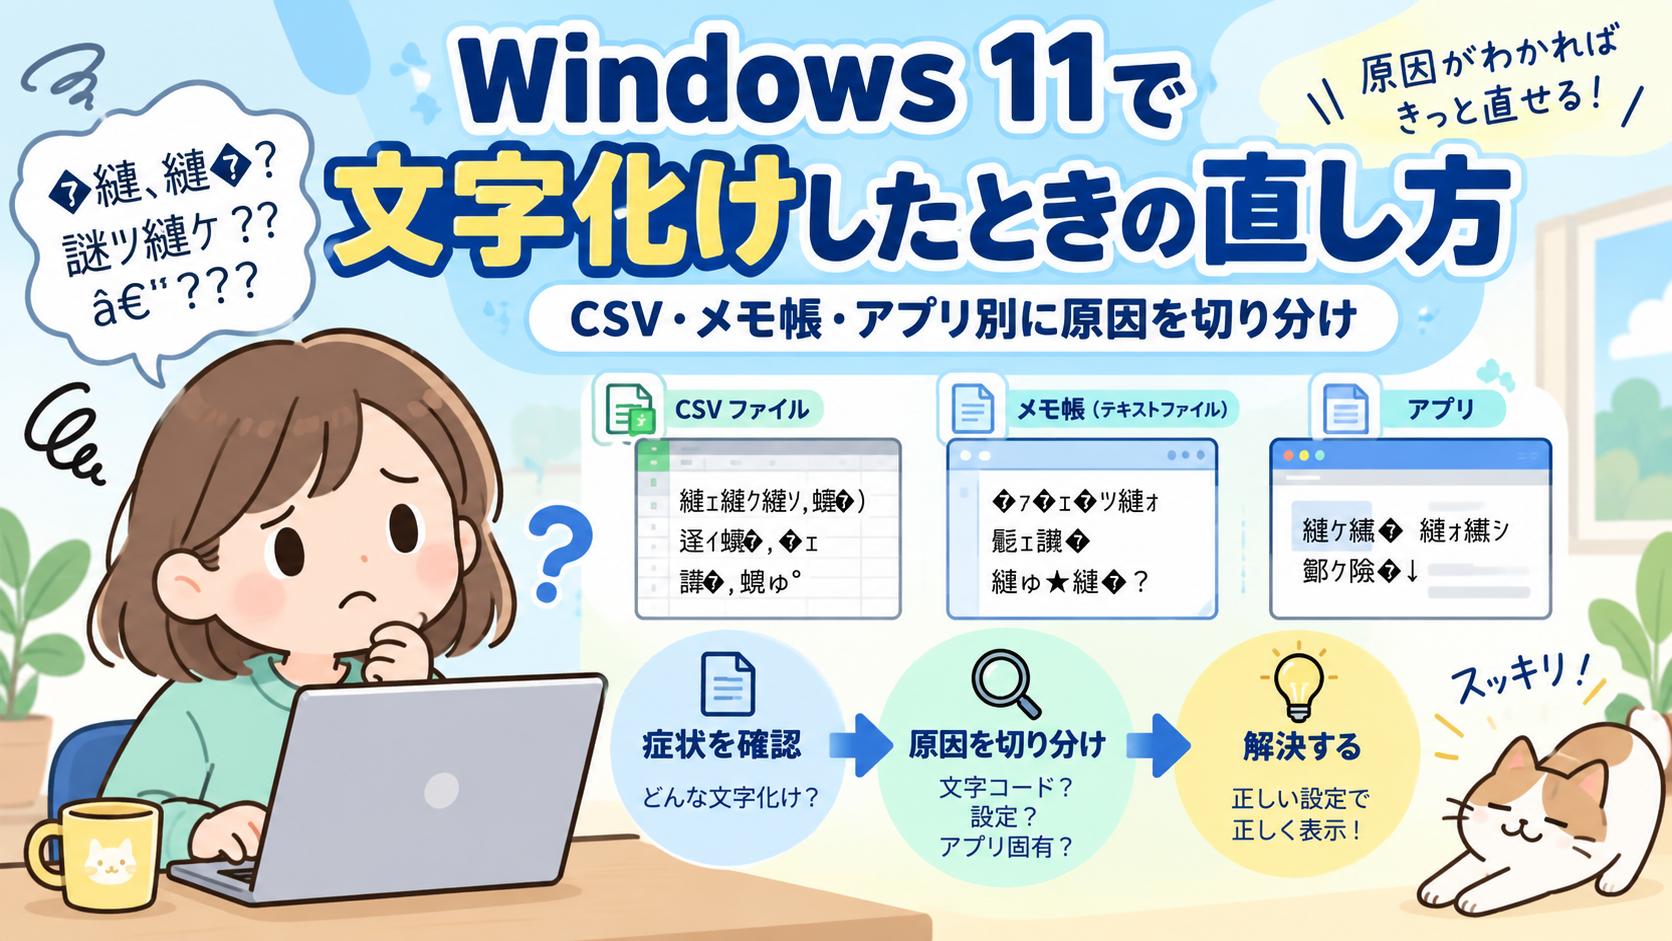
Windowsでファイルを開いたら、日本語が「縺」「譁」など意味不明な文字になったり、「□」「?」ばかり表示されたりすると、「ファイルが壊れた?」と焦りやすいところです。
結論からいうと、Windowsの文字化けは、最初からWindows全体の設定を変更するのではなく、「どこだけ文字化けしているか」で対処を分けるのが最短です。
| 症状 | 最初に試すこと |
|---|---|
| CSVをExcelで開いたら日本語だけ崩れる | Excelの「テキスト/CSVから」で読み込む |
| TXT・CSVが特定のエディタだけで崩れる | 別の文字コードとして開き直す |
| 古い業務ソフトだけ文字化けする | 非Unicodeアプリ用のシステムロケールを確認 |
| コマンドプロンプトだけ日本語が崩れる | コードページを確認 |
| PowerShellで作ったファイルだけ崩れる | PowerShellのバージョンと出力エンコードを確認 |
| 文字が「□」で表示される | 文字コードよりフォント不足を疑う |
| どのアプリで開いても同じ文字が「 」になっている | すでに保存内容が変化していないか確認 |
そして、文字化けを見つけた直後に最も大切なのは、読めない状態のまま上書き保存しないことです。
表示方法を間違えているだけなら元データは正常ですが、その状態で保存し直すと、本来残っていた文字情報まで失う可能性があります。
この記事では、Windows 11を中心に、CSV・Excel・メモ帳・古いアプリ・コマンドプロンプト・PowerShellなど、症状ごとの直し方を順番に解説します。
まずやること|文字化けしたファイルは上書きせずコピーを作る
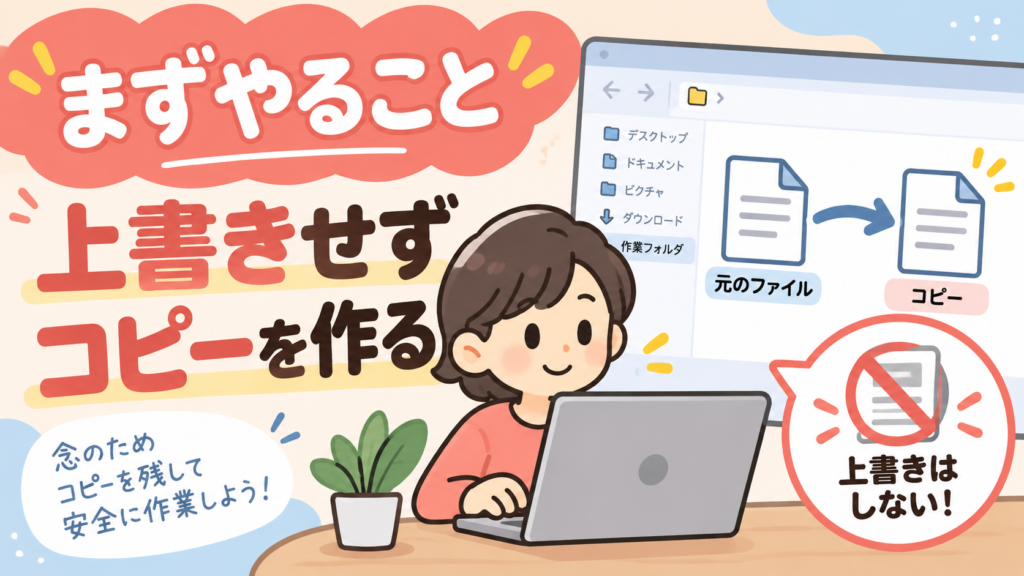
文字化けしたら、エンコード設定を片っ端から変える前に元ファイルを保全します。
- 文字化けしたファイルを閉じる
- エクスプローラーで元ファイルをコピーする
- 「元ファイル」と「確認用コピー」に分ける
- 以降の文字コード変更や保存はコピー側で試す
たとえば、
data.csv → data_original.csv と data_test.csv
のように分けておくと安心です。
「表示が壊れている」のか「データ自体が壊れている」のかを分ける
文字化けには大きく2種類あります。
| 状態 | 意味 |
|---|---|
| 別アプリ・別文字コードなら正常に読める | 元データは残っていて、読み方だけが違う可能性が高い |
| どこで開いても「 」「?」など同じ文字になっている | 保存時点で元の文字情報が失われている可能性がある |
特に「 」はUnicodeの置換文字として使われることがあります。
誤った読み込み結果を「 」のまま保存してしまった場合、あとから文字コードだけ変更しても元の文字へ戻せないことがあります。
文字コードを変更する前に、元ファイル・元メール・元システムから再取得できるかも確認しておきましょう。
文字化けの見た目だけで文字コードを断定しない
ネットでは「この文字が出たらUTF-8をShift_JISで読んでいる」といった早見表もあります。
ある程度の推測材料にはなりますが、見た目だけで断定するのはおすすめしません。
同じUTF-8のバイト列でも、Shift_JIS系・Windows-1252・Latin-1など、どの文字コードとして誤解釈したかによって表示結果は変わります。
実際の修復では、エディタやExcelの読み込み画面でエンコードを変更し、正常な日本語に戻るか確認するほうが確実です。
ExcelでCSVが文字化けしたら「ダブルクリック」せずインポートする
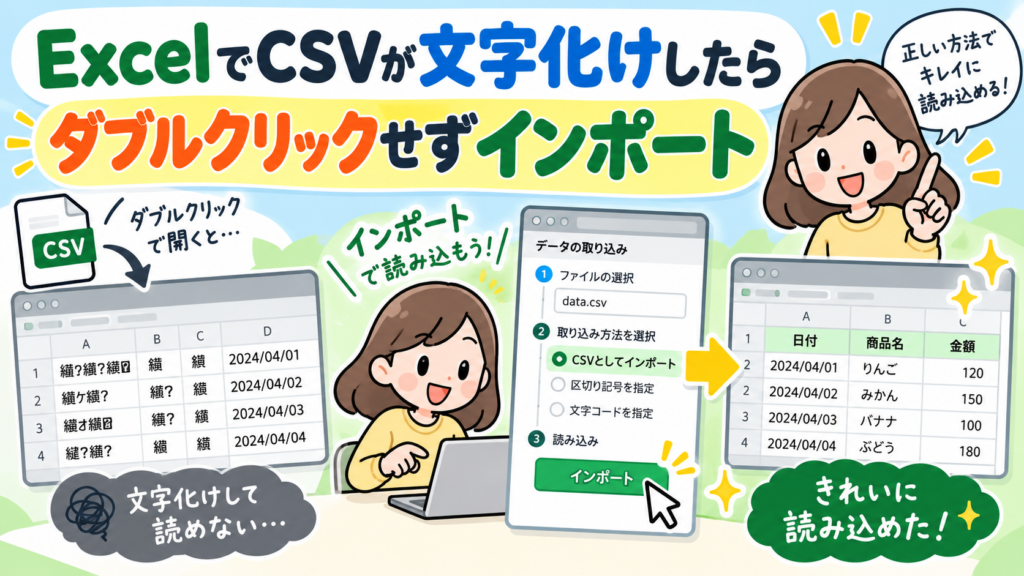
Windowsで最もよく起きる文字化けの一つが、Webサービスや業務システムからダウンロードしたCSVをExcelで開いたケースです。
この場合、ファイルを変換する前にExcel側で正しい文字コードとして読み込めるか試しましょう。
UTF-8 CSVをExcelで正しく開く手順
Microsoft公式では、UTF-8で保存されたCSVについて、BOM付きであれば通常どおり開くことができ、そうでない場合は「データの取得」から読み込む方法を案内しています。
現在のExcelでは、基本的に次の手順です。
- CSVをダブルクリックせずExcelを先に起動する
- 新しい空白のブックを開く
- 「データ」を選ぶ
- 「テキストまたはCSVから」を選ぶ
- 文字化けしているCSVを選択する
- プレビューで「ファイルの元」や文字コードを確認する
- UTF-8なら「65001: Unicode (UTF-8)」など正しく表示される設定を選ぶ
- 日本語が正常なのを確認して「読み込み」を選ぶ
Microsoft公式の現在の方法はMicrosoft公式「ExcelでCSV UTF-8ファイルを正しく開くには」で確認できます。
文字化けを直すだけなら、いきなりShift_JISへ変換しなくてもよい
CSVがUTF-8で正常に作られているのにExcelの開き方だけが原因なら、ファイルそのものをShift_JISへ変換する必要はありません。
Excel側で正しい文字コードを指定して読み込めば済みます。
むしろ、UTF-8からShift_JIS系へ変換すると、Shift_JIS系で表現できない文字を含んでいる場合に情報を失う可能性があります。
そのため、
「読めないから変換」ではなく、「まず正しく読み込む」
という順番がおすすめです。
Excelで保存するときは「CSV UTF-8」を選べる
別のシステムへUTF-8 CSVを渡したい場合は、Excelの「名前を付けて保存」から「CSV UTF-8(コンマ区切り)」を選択できます。
ただし、受け取るシステムがShift_JIS・CP932などを要求しているなら、その仕様を優先してください。
文字コードは「新しいものへ統一すれば必ず正解」というものではなく、読み込む側との約束で決まります。
TXT・メモ帳・VS Codeで文字化けしたときは「開き直す→確認→別名保存」
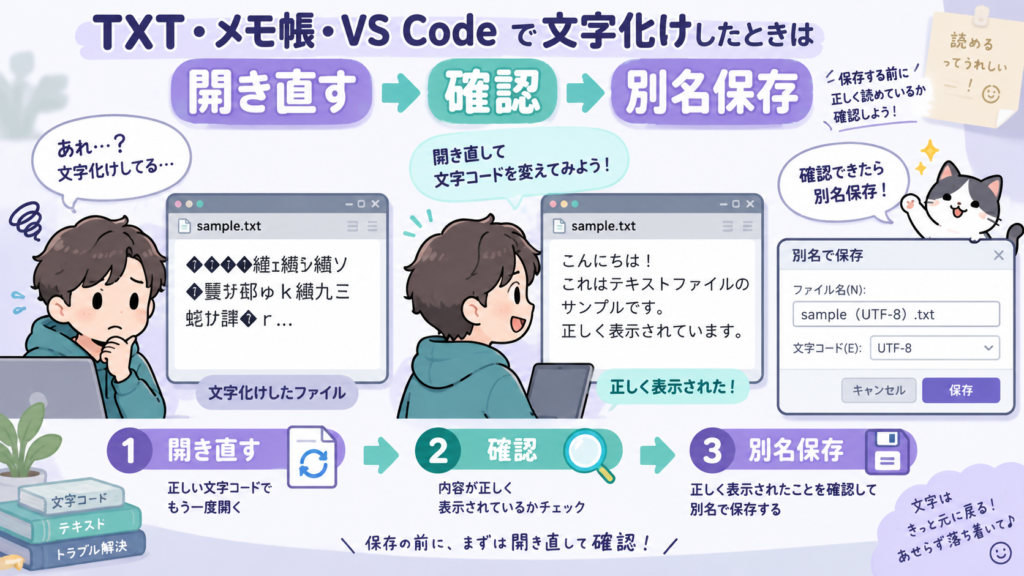
TXTなどのテキストファイルでは、保存されている文字コードとアプリが想定した文字コードが違うと文字化けします。
この場合も、読めない状態のまま別の文字コードへ「変換して保存」するのではなく、まず正しい文字コードとして開き直すことが重要です。
メモ帳で正常に見えるなら、すぐ変換しなくてもよい
現在のWindowsのメモ帳はUnicodeを扱えます。
メモ帳では正常なのに古い業務ソフトでだけ文字化けする場合、ファイルが壊れているのではなく、古いソフト側が期待する文字コードとの不一致が考えられます。
この場合は、
- 元ファイルはそのまま残す
- 相手ソフトが要求する文字コードを確認する
- 必要な場合のみコピーを別形式で保存する
という流れが安全です。
VS Codeなどでは「Reopen with Encoding」と「Save with Encoding」を区別する
対応エディタでは、
- 別の文字コードとして開き直す
- 現在の文章を別の文字コードへ変換して保存する
という2種類の操作があります。
文字化けの原因調査で最初に必要なのは前者です。
正しく表示できる文字コードを発見してから、必要なら別名保存すると覚えてください。
「ANSI」と「Shift_JIS」は完全に同じ言葉ではない
Windowsの日本語環境では、「ANSI」という表示が日本語のWindowsコードページを指す場面があります。
一般にShift_JISとまとめて説明されることも多いですが、WindowsではCP932(Windows-31J)と呼ばれるShift_JIS系の拡張が使われることがあります。
そのため、古い業務システムで「Shift_JIS対応」と書かれていても、実際にはWindowsのCP932を前提としている場合があります。
丸数字、ローマ数字、一部の特殊文字などで互換性問題が出たら、単なる「UTF-8かShift_JISか」だけでなく、相手システムの正式な仕様を確認してください。
古いソフトだけ文字化けするならシステムロケールを確認する
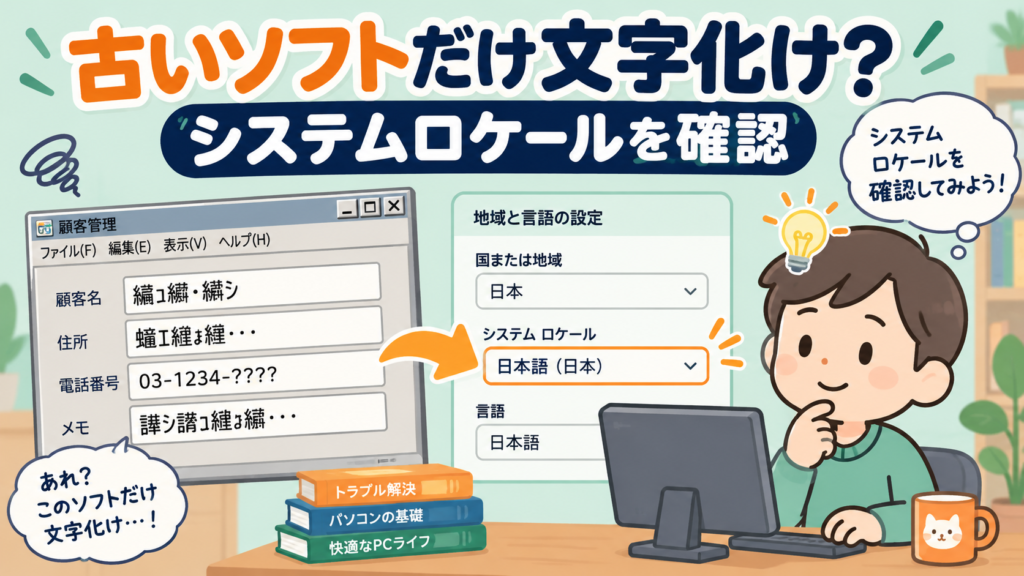
特定の古い業務ソフトや昔のゲームだけ日本語が文字化けし、Excelやブラウザ、メモ帳などは正常なら、Windowsのシステムロケールが関係している可能性があります。
Microsoftはシステムロケールについて、非Unicodeプログラムが使用する既定言語・コードページなどに影響する設定と説明しています。
つまり、これはWindows上のすべての文字化けを直す万能設定ではありません。
Microsoft Learn「SystemLocale」でも、非Unicodeアプリへ影響する設定であることを確認できます。
日本向けの古いアプリなら「日本語(日本)」になっているか確認
Windowsのバージョンによって画面の場所が多少異なりますが、「地域」の管理設定から「非Unicodeプログラムの言語」「システムロケール」などを確認できます。
日本向けに作られた古い非Unicodeソフトで文字化けするなら、現在のシステムロケールが「日本語(日本)」になっているか確認します。
ただし変更すると、別のレガシーアプリへ影響する可能性があります。
CSVが1個文字化けしただけでシステムロケールを変更する必要はありません。
「ベータ: ワールドワイド言語サポートでUnicode UTF-8を使用」は最初にONにしない
Windowsには、システムコードページをUTF-8として扱うための「ベータ: ワールドワイド言語サポートでUnicode UTF-8を使用」という設定があります。
Microsoft Learnでも、この設定によってシステム側でUTF-8コードページを利用できることが説明されています。
詳しくはMicrosoft Learn「Use UTF-8 code pages in Windows apps」で確認できます。
しかし、古い非Unicodeアプリの中には、システムコードページが従来と変わることで正常動作しなくなるものがあります。
実際にMicrosoftも過去のレガシーアプリ互換性問題で、このUTF-8設定を無効にする回避策を案内した事例があります。
そのため、
「文字化けした→UTF-8ベータ設定をON」
という一律の対処はおすすめしません。
まずアプリ単体・ファイル単体の原因を切り分け、それでも非Unicodeアプリのシステムコードページが原因だと判断できる場合に検討してください。
コマンドプロンプトとPowerShellは同じ対処をしない
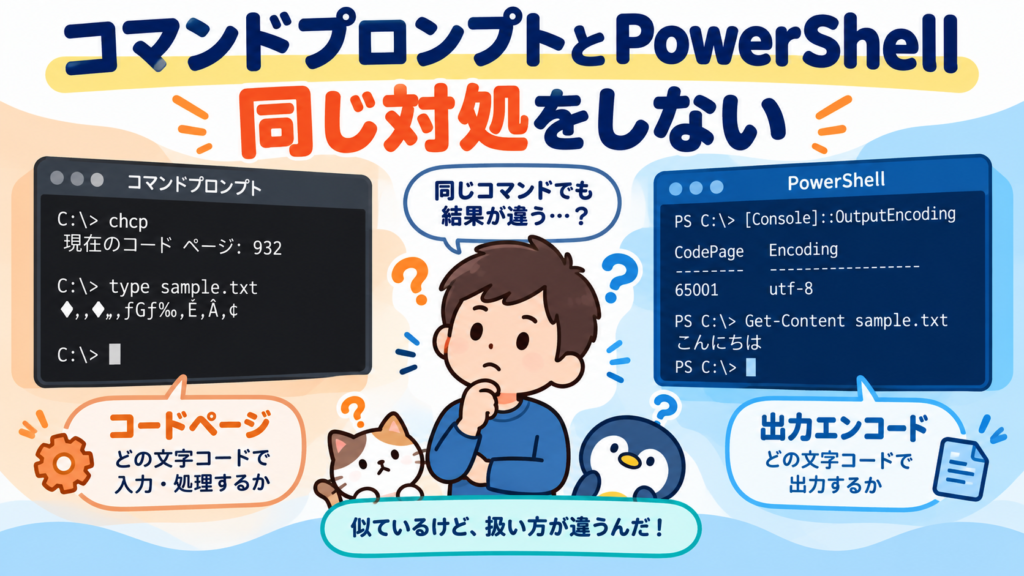
Windowsのコマンドラインで起きる文字化けは、通常のTXTやCSVとは少し事情が違います。
特に、画面表示の文字コードと、ファイルへ保存するときの文字コードを分けて考える必要があります。
コマンドプロンプトではchcpで現在のコードページを確認できる
コマンドプロンプトで次を実行すると、現在のアクティブなコードページを確認できます。
chcp
Microsoft公式によると、chcpはアクティブなコンソールコードページを表示・変更するコマンドです。
UTF-8へ変更する場合は、環境や使用するプログラムの対応を確認したうえで、
chcp 65001
を使用する方法があります。
正式な仕様はMicrosoft Learn「chcp」で確認できます。
ただし、chcpはコンソールのコードページを変えるもので、文字化けしたTXTファイルそのものを修復するコマンドではありません。
PowerShellはWindows PowerShell 5.1とPowerShell 7で既定値が違う
ここは、Windows文字化けの記事で特に間違いやすいところです。
Microsoft公式ドキュメントでは、文字出力時の既定エンコードがPowerShellの世代によって異なると説明されています。
| 環境 | 注意点 |
|---|---|
| Windows PowerShell 5.1 | コマンドごとに既定エンコードが一定ではない |
| PowerShell 6以降 | テキスト出力は基本的にUTF-8 BOMなし |
| PowerShell 7.4以降 | -Encoding ansiも利用可能 |
特にWindows PowerShell 5.1では、Out-Fileやリダイレクト、Set-Contentなどで挙動が異なります。
一方、PowerShell 7ではutf8はBOMなしUTF-8として扱われます。
詳しい違いはMicrosoft Learn「about_Character_Encoding」で確認できます。
スクリプトではエンコードを明示したほうが安全
業務でCSVやログを自動生成する場合は、PCやPowerShellのバージョン任せにせず、必要なエンコードを明示します。
PowerShell 7でUTF-8 BOMなしなら、たとえば次のように指定できます。
Set-Content -Path ".\sample.txt" -Value $data -Encoding utf8NoBOM
Excelへ直接ダブルクリックで渡すUTF-8 CSVなど、BOMが必要な用途なら、
-Encoding utf8BOM
を選べます。
利用可能な値はMicrosoft公式「Set-Content」で確認してください。
「-Encoding utf8」と書けばどのPowerShellでも完全に同じファイルになる」と考えないのがポイントです。
「□」「PDFだけ」「Webだけ」の文字化けは文字コード以外を疑う
何でもUTF-8とShift_JISの問題として扱うと、かえって遠回りになるケースがあります。
文字が「□□□□」ならフォント不足の可能性
文章の文字数に合わせるように四角形が並ぶ場合は、その文字を描画できるフォントがない可能性があります。
この場合、文字データ自体は正常なことがあります。
確認方法は、
- 別フォントへ変更する
- 別PCで開く
- ブラウザなど別アプリで同じ文章を表示する
ことです。
文字コードを何度も変換するより、フォントを切り分けてください。
PDFだけ文字化けするなら別のPDFビューアでも確認する
PDFでは、埋め込みフォント、PDFを作成したソフト、文字情報の持ち方などによって表示・コピー結果が変わることがあります。
たとえば、
- 見た目は正常だがコピーすると文字化けする
- 特定のPDFビューアだけ□になる
- 印刷すると正常なのに画面だけ崩れる
といった場合、Windowsのシステムロケールを変更しても解決しない可能性があります。
まずMicrosoft Edgeなど別のPDF表示方法でも確認し、PDFそのものの生成側に問題がないか切り分けましょう。
Webページの文字化けはHTMLとHTTPヘッダーの指定を確認する
自分で作成したWebページだけ文字化けする場合は、HTMLファイルをUTF-8へ保存するだけでは不十分な場合があります。
HTML内の文字コード指定と、WebサーバーがHTTPヘッダーで送る文字コードが食い違っていないか確認します。
一般的なHTML5では、HTML側に、
<meta charset="UTF-8">
などの指定を行います。
ブラウザだけで一時的に読める状態へ変更するより、送信元の設定を一致させるのが根本対策です。
メールの文字化けは受信者側だけで直せない場合がある
メール本文や件名の文字化けは、送信時のMIMEエンコードやContent-Typeなどが正しく付いていないことでも発生します。
同じメールをWebメールと別メールソフトで確認して、片方だけ文字化けするなら表示側、どこでも崩れるなら送信側の問題も疑います。
重要なメールなら、文字化けした文章を自己判断で変換し続けるより、送信者へ再送を依頼するほうが確実な場合があります。
二度と文字化けさせないための保存・受け渡しルール
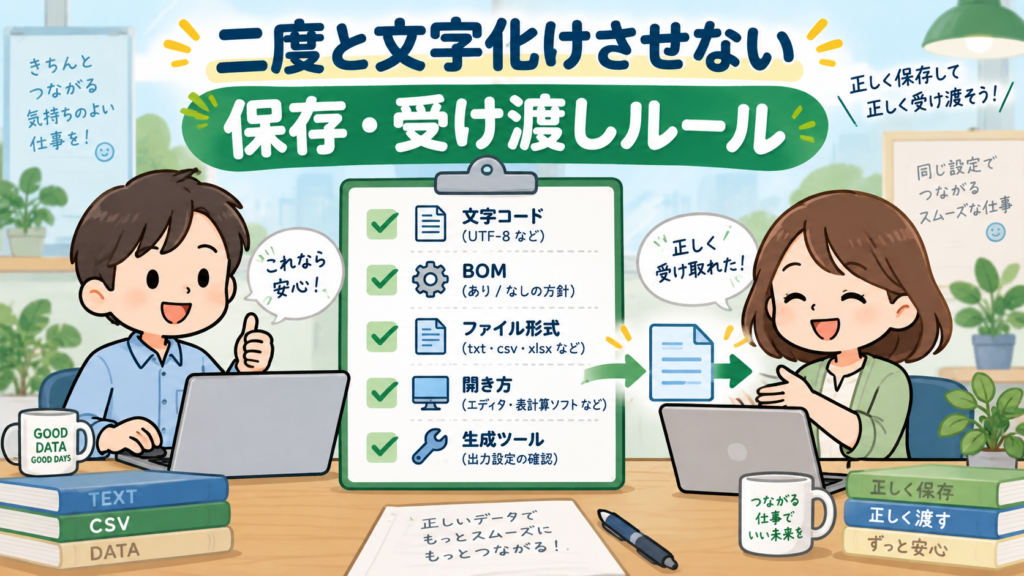
一度直せても、同じ業務で毎月文字化けするなら、個人の対処方法ではなく運用ルールを見直したほうが効果的です。
「UTF-8に統一」ではなく受け渡し先まで含めて決める
新しいシステム同士ならUTF-8が扱いやすいケースが多いですが、古い業務システムではCP932などを要求する場合があります。
そのため、次の項目をセットで決めます。
| 決めること | 例 |
|---|---|
| 文字コード | UTF-8 / CP932など |
| BOM | あり / なし |
| ファイル形式 | CSV / TSV / TXTなど |
| 区切り文字 | カンマ / タブなど |
| 開き方 | Excelへ直接ではなく「テキスト/CSVから」 |
| 生成ツール | Excel / PowerShell / 業務システムなど |
CSVでは文字化け以外にも「先頭0消失」に注意
CSVをExcelへ読み込む場合、文字化けだけ直して安心すると、別のデータ変換が起きることがあります。
たとえば、
- 郵便番号や商品コードの先頭0が消える
- 長い数字が指数表記になる
- 日付のような文字列が自動的に日付へ変換される
などです。
そのためExcelの「テキスト/CSVから」を使う場合は、文字コードだけでなく列のデータ型も必要に応じて確認してください。
文字化けが直った=データが完全に同じ、とは限りません。
社外から受け取った重要ファイルをオンライン変換サイトへ安易にアップロードしない
文字化けを自動修復するWebサービスもありますが、顧客情報・社員情報・契約情報・未公開データなどを含むCSVを第三者サイトへアップロードする場合は注意が必要です。
会社の情報セキュリティルールで認められているか確認し、機密ファイルならExcelや社内ツールなどローカル環境で対処するほうが適切な場合があります。
Windowsの文字化けについてよくある疑問
Windowsの文字化けはUTF-8に変更すれば全部直りますか?
いいえ。
CSVの読み込み方法、非Unicodeアプリ、フォント不足、PowerShellの出力など原因は複数あります。
むやみにWindows全体をUTF-8設定へ変更するのではなく、文字化けしているアプリ・ファイルを先に特定してください。
CSVがExcelだけ文字化けします。ファイルは壊れていますか?
必ずしも壊れていません。
Microsoft公式では、BOMなしのUTF-8 CSVなどについて、Excelの「データ→テキスト/CSVから」などで読み込む方法を案内しています。
別のテキストエディタでは正常に読めるなら、Excelの読み込み方法を先に確認してください。
UTF-8 BOM付きにすればExcelでは必ず大丈夫ですか?
Microsoftは、UTF-8 CSVがBOM付きで保存されている場合は通常どおり開けると案内しています。
ただしCSV内の列型や区切り文字などは別問題です。
また、他システムがBOMなしUTF-8を要求する場合もあるため、Excelだけを基準に保存形式を決めないでください。
「ベータ: Unicode UTF-8」をONにすると直りますか?
非Unicodeアプリの動作へ影響する可能性はありますが、一般的なCSVやTXTの文字化けを直す最初の対処ではありません。
古いアプリとの互換性へ影響する可能性もあるため、原因を特定せず一律にONへ変更するのは避けましょう。
chcp 65001を実行すれば文字化けしたファイルが直りますか?
いいえ。
chcpはコマンドプロンプトなどのアクティブなコンソールコードページを変更するコマンドです。
保存済みファイルの文字コードそのものを修復するコマンドではありません。
PowerShellの「-Encoding utf8」はBOM付きですか?
PowerShellのバージョンによって違います。
Microsoft公式では、Windows PowerShell 5.1のUTF8はBOM付きですが、PowerShell 6以降ではUTF-8 BOMなしが基本となっています。
バージョン差を避けたい場合は、PowerShell 7ではutf8BOMやutf8NoBOMのように意図を明示すると分かりやすくなります。
文字化けした状態で保存してしまいました。戻せますか?
元データのバイト列が残っているなら、正しい文字コードで開き直せる可能性があります。
一方、誤って読み取った文字列を別内容として上書きし、「 」や「?」に置き換わった状態で保存している場合は、元の文字情報を失っている可能性があります。
元ファイル、バックアップ、クラウドの版履歴、送信元データなどから復旧できないか確認してください。
まとめ|文字化けは「どこだけ崩れるか」を見ると最短で直しやすい
Windows 11で文字化けしたときは、最初から文字コードを変換したり、Windows全体の設定を変更したりする必要はありません。
まず次の順番で確認してください。
- 元ファイルをコピーし、上書きしない
- どのアプリ・どのファイルだけ文字化けするか確認する
- ExcelのCSVなら「テキスト/CSVから」で正しい文字コードとして読み込む
- TXTなら別のエンコードとして開き直して確認する
- 古いアプリだけならシステムロケールを確認する
- コマンドプロンプトならコードページ、PowerShellなら出力エンコードを確認する
- □表示ならフォント不足も疑う
特に避けたいのは、文字化けした画面のまま「UTF-8へ変換」「Shift_JISへ変換」と上書きを繰り返すことです。
元のデータが正常なら、読み込み方法を変えるだけで直るケースがあります。
ExcelのUTF-8 CSVについては、Microsoftも「データ→テキスト/CSVから」などの読み込み方法を公式に案内しています。
また、Windowsのシステムロケールは非Unicodeアプリ向け、chcpはコンソール向け、PowerShellの-Encodingはファイル出力向けです。
同じ「文字化け」という見た目でも、直す場所は違います。
「CSVだけ」「古いアプリだけ」「コマンド画面だけ」「□だけ」というように症状を分けてから対処すれば、関係ないWindows設定まで変更せず、安全に復旧しやすくなります。